使用LangChain构建RAG管道:从文档处理到向量搜索
6月 15, 2026· ·
2 分钟阅读时长
杨劲松
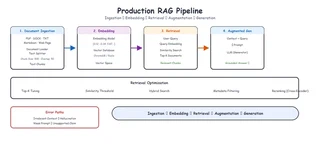
检索增强生成(RAG)已成为构建需要访问特定知识库的AI应用的标准方法。本指南将介绍如何使用LangChain从零开始构建完整的RAG管道。
上图:Production RAG Pipeline — 文档摄入 → 向量嵌入 → 检索 → 增强生成 → 输出
目录
什么是RAG?
RAG结合了大语言模型和外部知识检索的能力:
用户查询 → 检索 → 上下文 + 查询 → LLM → 回答
这种方法解决了LLM的核心问题:它们只能基于训练数据回答问题。RAG允许它们访问最新的、特定领域的或私有的信息。
文档处理
第一步是为检索准备文档:
from langchain.document_loaders import PyPDFLoader
from langchain.text_splitter import TokenTextSplitter

# 加载文档
loader = PyPDFLoader("knowledge_base.pdf")
documents = loader.load()

# 分割为块
text_splitter = TokenTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    encoding_name="cl100k_base"  # OpenAI分词器
)

chunks = text_splitter.split_documents(documents)
关键考虑
- 块大小 - 平衡上下文和检索准确性
- 重叠 - 防止重要信息被分割到不同块中
- 元数据 - 保留源信息用于归属
向量存储
存储嵌入以进行高效相似性搜索:
from langchain.embeddings import OpenAIEmbeddings
from langchain.vectorstores import Redis

# 初始化嵌入
embeddings = OpenAIEmbeddings()

# 创建向量存储
vector_store = Redis.from_documents(
    documents=chunks,
    embedding=embeddings,
    redis_url="redis://localhost:6379",
    index_name="knowledge_base"
)
选择向量存储
| 存储 | 性能 | 功能 | 最佳用途 |
|---|---|---|---|
| Redis | 高 | 实时更新 | 生产环境 |
| Pinecone | 高 | 托管服务 | 企业级 |
| FAISS | 中 | 本地、免费 | 开发环境 |
| Chroma | 中 | 简单设置 | 原型开发 |
检索策略
使用LangChain实现智能检索:
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import LLMChainExtractor

# 基本相似性搜索
retriever = vector_store.as_retriever(
    search_type="similarity",
    search_kwargs={"k": 5}
)

# 高级:上下文压缩
compressor = LLMChainExtractor.from_llm(llm)
compression_retriever = ContextualCompressionRetriever(
    base_compressor=compressor,
    base_retriever=retriever
)
幻觉预防
对生产级RAG系统至关重要:
from langchain.prompts import ChatPromptTemplate

system_prompt = """你是一位农业专家。仅基于提供的上下文回答问题。如果上下文没有包含足够的信息,请说"我没有足够的信息来回答这个问题。"

上下文:{context}
"""

prompt = ChatPromptTemplate.from_messages([
    ("system", system_prompt),
    ("human", "{input}")
])
三层预防
- 检索过滤 - 仅传递高相关性文档
- 提示词工程 - 强制模型引用来源
- 输出验证 - 验证响应与源数据
流式接口
使用FastAPI实现实时响应:
from fastapi import FastAPI
from fastapi.responses import StreamingResponse
import asyncio

app = FastAPI()

@app.post("/chat")
async def chat(query: str):
    async def generate():
        async for chunk in chain.astream({"input": query}):
            yield f"data: {chunk.content}\n\n"
            await asyncio.sleep(0.01)  # 模拟打字效果
        yield "data: [DONE]\n\n"

    return StreamingResponse(
        generate(),
        media_type="text/event-stream"
    )
生产环境考虑
1. 错误处理
try:
    response = await chain.ainvoke({"input": query})
except Exception as e:
    logger.error(f"RAG错误: {e}")
    return {"error": "生成响应失败"}
2. 缓存
from langchain.cache import RedisCache

cache = RedisCache(redis_url="redis://localhost:6379")
llm = OpenAI(cache=cache)
3. 监控
跟踪关键指标:
- 检索准确性
- 响应延迟
- 用户满意度
- 幻觉率
总结
构建生产级RAG系统需要关注:
- 文档质量 - 良好的预处理至关重要
- 检索策略 - 平衡精确率和召回率
- 幻觉预防 - 多层次方法
- 用户体验 - 流式传输和错误处理
完整代码可在 GitHub 上获取。
有问题?通过 GitHub 或邮件 yjs_0831@qq.com 联系我!
