RAG系统中的三层幻觉预防:实践指南
8月 5, 2026· ·
5 分钟阅读时长
杨劲松
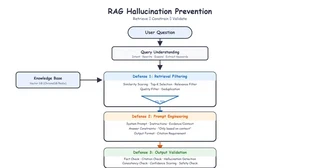
幻觉是部署LLM用于生产环境时最大的挑战之一。本指南介绍了一种实用的三层方法来预防RAG系统中的幻觉。
上图:RAG幻觉预防的三层防御架构 —— 检索过滤 → 提示词工程 → 输出验证
目录
理解幻觉
幻觉是指LLM生成看似合理但事实不正确的信息。在RAG系统中,这通常发生在:
- 检索到的上下文不相关或不足
- LLM优先使用其训练数据而非提供的上下文
- 模型用编造的信息"填补空白"
常见场景
- 产品信息 - LLM编造价格、规格或可用性
- 医疗/农业建议 - 生成错误的剂量或治疗方法
- 法律/财务 - 创建不存在的法规或政策
第一层:检索过滤
确保只有相关信息到达LLM:
from langchain.retrievers import ContextualCompressionRetriever
from langchain.retrievers.document_compressors import LLMChainExtractor

class RetrievalFilter:
    def __init__(self, vector_store, llm):
        self.vector_store = vector_store
        self.llm = llm

    def filter_documents(self, query: str, threshold: float = 0.7):
        """按相关性过滤检索到的文档。"""
        # 获取初始结果
        results = self.vector_store.similarity_search_with_score(query, k=10)

        # 按分数阈值过滤
        filtered = [
            (doc, score)
            for doc, score in results
            if score >= threshold
        ]

        # 使用LLM重新排序
        reranked = self.rerank_with_llm(query, filtered)

        return reranked

    def rerank_with_llm(self, query: str, documents):
        """使用LLM按相关性重新排序文档。"""
        prompt = f"""根据查询对这些文档按相关性排序:{query}

文档:
{[doc.page_content for doc, _ in documents]}

返回最相关的文档索引(逗号分隔):"""

        response = self.llm.predict(prompt)
        # 解析并返回顶级文档
        # 实现细节...
过滤策略
- 分数阈值 - 移除低相关性文档
- 多样性过滤 - 确保多样化的视角
- 来源验证 - 优先考虑权威来源
- 时效性过滤 - 偏好最新信息
第二层:提示词工程
设计约束LLM行为的提示词:
HALLUCINATION_PREVENTION_PROMPT = """你是一个有用的助手。仅基于提供的上下文回答问题。

规则:
1. 如果上下文没有包含足够的信息,请说"我没有足够的信息来回答这个问题。"
2. 永远不要编造上下文中不存在的信息。
3. 尽可能引用源文档。
4. 如果多个来源冲突,请呈现两种观点。
5. 对于数值数据,引用上下文中的确切数字。

上下文:
{context}

问题:{input}

回答:"""
按领域的提示词模板
电商产品:
ECOMMERC_PROMPT = """你是产品专家。仅使用提供的产品信息回答产品问题。

规则:
1. 永远不要编造价格、规格或可用性
2. 如果产品信息不完整,请说"我没有关于此产品的完整信息"
3. 始终提及数据中的产品名称和关键特性
4. 对于比较,严格坚持提供的数据

产品信息:
{context}

问题:{input}
"""
农业知识:
AGRICULTURAL_PROMPT = """你是农业专家。仅使用提供的知识库回答农业问题。

规则:
1. 永远不要编造农药剂量或治疗方法
2. 如果知识库没有涵盖特定作物/病害,建议咨询当地专家
3. 尽可能引用源手册
4. 对于安全关键建议,包含适当的警告

知识库:
{context}

问题:{input}
"""
第三层:输出验证
根据源数据验证LLM响应:
import re
from typing import Dict, List, Tuple

class OutputValidator:
    def __init__(self, llm):
        self.llm = llm

    def validate_response(self, response: str, context: str) -> Dict:
        """根据源上下文验证LLM响应。"""
        validation_results = {
            "is_valid": True,
            "issues": [],
            "corrected_response": response
        }

        # 检查1:数值声明
        numerical_issues = self.check_numerical_claims(response, context)
        if numerical_issues:
            validation_results["issues"].extend(numerical_issues)

        # 检查2:实体验证
        entity_issues = self.verify_entities(response, context)
        if entity_issues:
            validation_results["issues"].extend(entity_issues)

        # 检查3:来源引用
        citation_issues = self.check_citations(response, context)
        if citation_issues:
            validation_results["issues"].extend(citation_issues)

        # 如果发现问题,生成修正后的响应
        if validation_results["issues"]:
            validation_results["corrected_response"] = self.generate_corrected_response(
                response, validation_results["issues"], context
            )
            validation_results["is_valid"] = False

        return validation_results

    def check_numerical_claims(self, response: str, context: str) -> List[str]:
        """验证响应中的数值在上下文中存在。"""
        issues = []

        # 从响应中提取数字
        numbers = re.findall(r'\b\d+(?:\.\d+)?(?:%|元|kg|ml)?\b', response)

        for number in numbers:
            if number not in context:
                issues.append(f"数值 '{number}' 在源上下文中未找到")

        return issues

    def verify_entities(self, response: str, context: str) -> List[str]:
        """验证产品/实体名称在上下文中存在。"""
        issues = []

        # 简单实体提取(可增强NER)
        entities = re.findall(r'[A-Z][a-z]+(?:\s[A-Z][a-z]+)*', response)

        for entity in entities:
            if entity.lower() not in context.lower():
                issues.append(f"实体 '{entity}' 在源上下文中未找到")

        return issues
实现示例
完整的三层预防系统:
from langchain.chains import LLMChain
from langchain.prompts import ChatPromptTemplate

class HallucinationPreventionSystem:
    def __init__(self, vector_store, llm):
        self.vector_store = vector_store
        self.llm = llm
        self.retrieval_filter = RetrievalFilter(vector_store, llm)
        self.output_validator = OutputValidator(llm)

    def query(self, user_input: str) -> Dict:
        """使用三层幻觉预防处理查询。"""

        # 第一层:过滤检索
        filtered_docs = self.retrieval_filter.filter_documents(user_input)
        context = "\n\n".join([doc.page_content for doc in filtered_docs])

        # 第二层:使用约束提示词生成响应
        prompt = ChatPromptTemplate.from_template(HALLUCINATION_PREVENTION_PROMPT)
        chain = LLMChain(llm=self.llm, prompt=prompt)
        response = chain.invoke({"context": context, "input": user_input})

        # 第三层:验证输出
        validation = self.output_validator.validate_response(
            response["text"], context
        )

        return {
            "response": validation["corrected_response"],
            "is_valid": validation["is_valid"],
            "issues": validation["issues"],
            "sources": [doc.metadata.get("source") for doc in filtered_docs]
        }
效果衡量
跟踪关键指标以评估预防系统:
class HallucinationMetrics:
    def __init__(self):
        self.metrics = {
            "total_queries": 0,
            "hallucinations_detected": 0,
            "false_positives": 0,
            "retrieval_accuracy": 0
        }

    def evaluate_response(self, response: str, context: str, ground_truth: str):
        """评估响应质量和幻觉存在情况。"""
        self.metrics["total_queries"] += 1

        # 检查幻觉
        if self.detect_hallucination(response, context):
            self.metrics["hallucinations_detected"] += 1

        # 与真实情况比较
        accuracy = self.calculate_accuracy(response, ground_truth)
        self.metrics["retrieval_accuracy"] += accuracy

    def detect_hallucination(self, response: str, context: str) -> bool:
        """简单幻觉检测。"""
        # 检查响应是否包含上下文中没有的信息
        response_words = set(response.lower().split())
        context_words = set(context.lower().split())

        # 响应中有但上下文中没有的词
        novel_words = response_words - context_words

        # 如果太多新词,可能是幻觉
        return len(novel_words) > len(response_words) * 0.3
指标仪表板
| 指标 | 描述 | 目标 |
|---|---|---|
| 幻觉率 | 包含幻觉的响应百分比 | < 5% |
| 检索准确性 | 检索到的相关文档百分比 | > 90% |
| 响应质量 | 用户满意度评分 | > 4.5/5 |
| 延迟 | 包含验证的响应时间 | < 2秒 |
总结
预防RAG系统中的幻觉需要多层次方法:
- 检索过滤 - 确保只有相关信息到达LLM
- 提示词工程 - 使用清晰指令约束LLM行为
- 输出验证 - 根据源数据验证响应
完整实现可在 GitHub 上获取。
有问题?通过 GitHub 或邮件 yjs_0831@qq.com 联系我!
