生产级 MySQL 高并发架构:缓存、读写分离与分片
8月 21, 2026· ·
3 分钟阅读时长
杨劲松
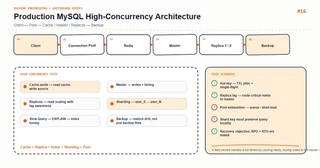
上图:Production MySQL High-Concurrency Architecture 白板图;重点不是罗列名词,而是把一次真实请求如何穿过系统、在哪些边界失败画清楚。
为什么要从场景理解这张图
这张图围绕“A feed service handles a hot tenant by caching reads, routing writes to the master, and testing restore before launch.”展开。学习 Production MySQL High-Concurrency Architecture 时,不能只记住组件名称:要能说明输入从哪里来、状态由谁持有、哪个组件承担失败、以及如何用指标证明系统仍然健康。白板中的箭头对应代码边界,红色感叹号对应需要显式处理的风险。
逐层拆解
主流程是:Client → Pool → Cache / Master / Replicas → Backup。前半段是请求或数据的进入路径,后半段是运行时、存储或执行结果。
- 边界契约:先确定输入、输出和错误结构;不要让隐式类型、未校验参数或共享可变状态穿透多层。
- 核心机制:Cache-aside → read cache, write source;Master → writes + binlog。这些机制决定延迟、吞吐和可测试性。
- 资源与状态:Replicas → read scaling with lag awareness;Sharding → user_0 … user_N。生产系统必须说明资源何时创建、何时释放,以及状态是否可恢复。
- 失败路径:Slow Query → EXPLAIN → index tuning;必要时再结合 Backup → restore drill, not just backup files 做降级、重试或回滚。
一个可落地的最小实现
下面的片段只展示边界,不代表完整业务。它的价值在于把“可以替换、可以测试、可以观测”的位置固定下来。
read: Redis → Replica → Master fallback
write: idempotency → Master → binlog / event
在真实项目中,应把外部依赖封装在 adapter 或 repository 中;业务层只依赖稳定接口。这样本地测试可以使用 fake,压测可以替换慢依赖,线上故障也更容易定位。
场景中的工程决策
以白板右侧的生产场景为例:
- 先保护依赖:连接池、线程池、并发信号量或缓存都要有上限,不能用无限队列掩盖下游过载。
- 再保证正确性:幂等键、事务边界、版本号、锁或 schema 校验至少要有一种明确机制,避免重试带来重复写入。
- 最后优化性能:先用 trace、慢查询、GC pause、队列长度、p99 延迟等数据定位,再选择索引、缓存、批处理或并发策略。
- 让故障可恢复:超时、重试、限流、熔断、回滚和告警必须能在演练中被验证,而不是只写在文档里。
常见误区
- 只画成功路径,没有画超时、空数据、拒绝、回滚或副本延迟。
- 把框架默认行为当成业务契约,升级依赖后才发现边界改变。
- 用“加机器”替代测量,忽略连接池、锁竞争、慢 SQL、对象分配或事件循环阻塞。
- 将日志当作唯一观测手段,缺少指标、trace、采样和敏感数据脱敏。
生产检查清单
- 输入、输出和错误响应有明确 schema
- 外部调用设置 timeout、retry 上限、rate limit 和 fallback
- 资源池有容量、排队和拒绝指标
- 关键状态有幂等、事务或恢复策略
- 日志、metrics、trace 可关联同一个 request id
- 用接近生产的数据做回归、压测和故障演练
总结
真正掌握这张白板图,不是能背出每个框的定义,而是能从一次具体请求出发,解释每个箭头的输入输出、每个风险的处置方式,以及上线后用什么信号判断系统需要改进。
