OpenAI API 基础:请求、消息、参数与可靠性
8月 21, 2026· ·
2 分钟阅读时长
杨劲松
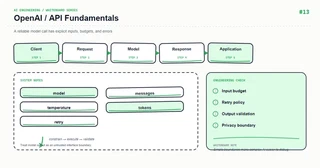
上图:OpenAI — OpenAI API 基础。
调用模型 API 的核心不是记住一个 endpoint,而是把网络请求当作不可靠的外部依赖。请求契约、超时、错误分类和用量记录必须在第一天就设计好。
核心心智模型
请求由 system/developer 规则、user 输入和可选工具组成;模型输出只是候选结果,应用层仍需验证、过滤和持久化。
关键机制
区分 4xx 参数/权限错误、429 限流、5xx 上游故障和本地超时;只对可重试类别做带抖动的指数退避,并设置总预算。
Python 示例
import asyncio, random

async def call_with_retry(client, request, attempts=3):
    for n in range(attempts):
        try:
            return await client.responses.create(**request, timeout=20)
        except (TimeoutError, RateLimitError):
            if n == attempts - 1: raise
            await asyncio.sleep((2 ** n) + random.random())
课程定位
这篇文章把白板上的模块拆成可以落地的工程边界:先定义输入和输出,再决定状态、失败策略与可观测性。示例使用 Python,重点是设计原则而不是绑定某个供应商版本;上线前请以当前依赖的官方文档为准。
工程实践
- 将业务规则放在应用层,不要藏进难以测试的提示词或路由函数。
- 为外部调用设置超时、重试上限和幂等键;重试不是错误处理的全部。
- 记录 request id、耗时、输入版本、模型/索引版本和结果状态,避免记录敏感原文。
- 用小规模固定数据集做回归测试,再用线上抽样监控质量与成本。
常见错误
- 只画 happy path,没有画超时、空结果、限流和回滚路径。
- 让一个函数同时负责解析、调用外部服务、拼接提示词和持久化。
- 用字符串约定代替类型契约,导致改动只能靠人工联调。
生产检查清单
- 输入、输出和错误响应均有明确 schema
- 外部依赖有 timeout、retry、rate limit 和 fallback
- 日志、指标、trace 能关联到同一次请求
- 关键路径有单元测试、集成测试和一组离线评测样本
- 密钥、用户内容和供应商响应按最小权限与隐私策略处理
练习建议
先实现白板中的最小闭环,再故意注入一个超时、一个空结果和一个格式错误,观察系统能否给出稳定且可诊断的结果。最后补一条指标,证明你的优化确实改善了质量或延迟。
动手练习
为一次调用增加 request id、耗时、输入/输出 token 和错误类别日志;再用模拟 429 与 400 的 fake client 验证只有 429 会重试。
总结
当白板上的每个箭头都能对应到一个输入、输出和失败策略时,AI 功能才从 demo 变成可维护的系统。
